 DuneTech Labs
Por qué la misma frase cuesta distinto
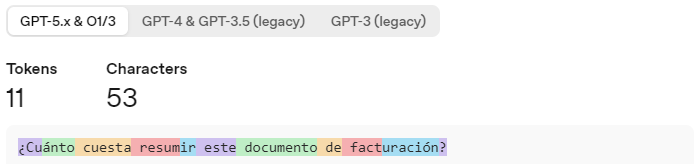
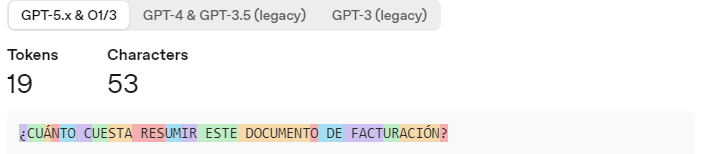
OpenAI lo dice así: una palabra se puede partir en distintos tokens según cómo se escriba, si lleva mayúsculas y qué tiene alrededor; los espacios también cuentan. Volvimos a medir la pregunta de la publicación, y otros textos, el 17 de octubre en el tokenizador de OpenAI (la página que muestra cómo parte un texto), con la misma opción, GPT-5.x:
| Texto | Caracteres | Tokens | Cómo se parte |
|---|---|---|---|
| ¿Cuánto cuesta resumir este documento de facturación? | 53 | 11 | ¿Cu · ánto · cuesta · resum · ir · este · documento · de · fact · uración · ? |
| ¿CUÁNTO CUESTA RESUMIR ESTE DOCUMENTO DE FACTURACIÓN? | 53 | 19 | ¿ · CU · Á · N · TO · C · UE · STA · … |
| facturación | 11 | 2 | fact · uración |
| FACTURACIÓN | 11 | 3 | FACT · UR · ACIÓN |
| $12,345.67 | 10 | 6 | $ · 12 · , · 345 · . · 67 |
| 17/10/2026 | 10 | 6 | 17 · / · 10 · / · 202 · 6 |
| Ciudad Juárez, Chihuahua | 24 | 5 | Ciudad · Ju · árez · , · Chihuahua |
La misma pregunta, toda en mayúsculas, son 8 tokens más. Las cifras y las fechas se parten en pedazos chicos. Es una medición con una sola forma de partir el texto, la de GPT-5.x: otros modelos pueden partirlo distinto.
Imágenes y PDF
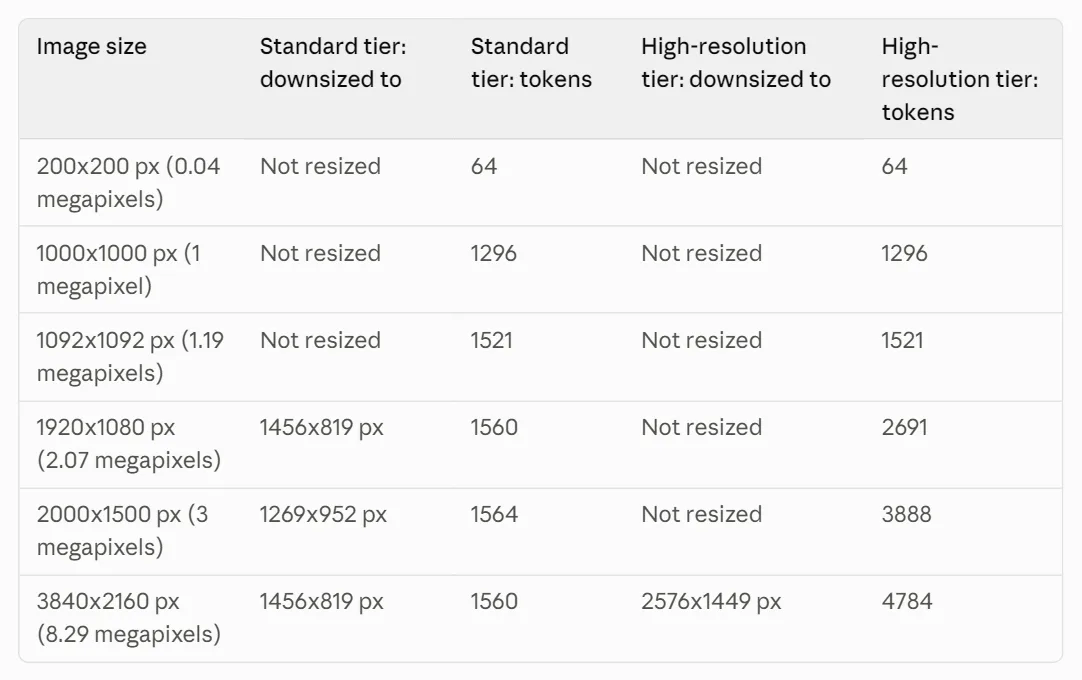
Una imagen también se convierte en tokens, y cada proveedor la cuenta a su manera:
- Anthropic la parte en cuadros de 28 por 28 píxeles; cada cuadro es un token. Una imagen de 1000 × 1000 píxeles son 1,296 tokens. Las que pasan del tope se reducen antes: en los modelos anteriores a Claude 4.7, a 1,568 píxeles en el lado largo y 1,568 tokens como máximo; desde 4.7, a 2,576 píxeles y 4,784 tokens. Por eso una foto de 1920 × 1080 son 1,560 tokens en los anteriores (se reduce a 1456 × 819) y 2,691 en los nuevos, que pueden usar hasta cerca de tres veces más por la misma imagen.
- OpenAI, en GPT-6 Astra, parte la imagen en cuadros de 32 por 32 píxeles y cobra cada cuadro como 1.2 tokens: una imagen de 1024 × 1024 en detalle alto son 1,024 cuadros, 1,229 tokens. Su guía no da la regla para GPT-6.1 Sol ni GPT-6 Luna, y advierte que el detalle bajo no siempre gasta menos que el alto.
- Google, en Gemini 3, asigna un número aproximado de tokens por imagen según la resolución que se pida: de 280 en baja a 2,240 en la más alta; 1,120 por omisión.
Con los PDF pasa algo parecido, porque cada página se lee como texto y como imagen. En OpenAI, desde GPT-5.6 las páginas se procesan por omisión en detalle alto, y se puede pedir el bajo para gastar menos; el texto que se extrae entra de todos modos. Google cuenta, por omisión, unos 560 tokens por página en Gemini 3, dice que la calidad casi no mejora por encima de esa resolución, y no cobra los tokens del texto que ya trae el PDF.
Cómo bajar el costo: el caché y los lotes
El caché sirve cuando se manda varias veces lo mismo, por ejemplo, el mismo manual o el mismo contrato con preguntas distintas. La primera vez se guarda; las siguientes, el modelo lo vuelve a leer mucho más barato. Solo funciona si el principio de lo que se manda es idéntico.
| OpenAI | Anthropic | ||
|---|---|---|---|
| Cómo se activa | Automático, en los modelos que lo admiten | Hay que pedirlo en cada solicitud | Automático, desde Gemini 2.5 |
| Lo que se vuelve a leer | 10% del precio normal desde GPT-5.6 (5% en GPT-6.1 Sol) | 10% del precio normal (5% en Opus 5.5 y Sonnet 5.5; 2.5% en Fable 5.1) | Gemini 3.8 Flash: 0.075 dólares el millón, contra 0.75 |
| Guardarlo | 1.25 veces el precio normal (desde GPT-5.6) | 1.25 veces, si dura 5 minutos; 2 veces, si dura una hora | En el caché que se pide a propósito, 0.50 dólares por millón de tokens por cada hora guardado (Gemini 3.8 Flash); para el automático, su guía no da un cargo |
| Mínimo | 1,024 tokens (desde GPT-5.6) | 512 tokens en los modelos actuales (Fable 5.1, Opus 5.5 y Sonnet 5.5) | 4,096 tokens en Gemini 3.8 Flash |
| Cuánto dura | Al menos 30 minutos después de la última vez que se usó | 5 minutos (o una hora), y se renueva cada vez que se usa | El automático: su guía no lo dice. El que se pide a propósito: una hora, si no se indica otra |
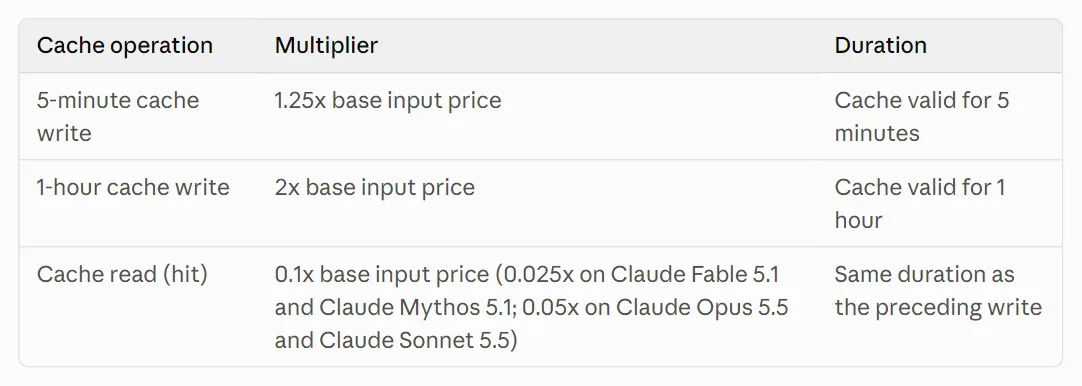
Anthropic aclara que lo guardado en caché ocupa la ventana de contexto (todo lo que el modelo tiene a la vista en una solicitud) igual que lo demás: el caché cambia lo que se paga por esos tokens, no si cuentan.
Los lotes son muchas solicitudes que se mandan juntas y que el proveedor responde cuando puede. Sirven cuando no hace falta la respuesta al momento: OpenAI, Anthropic y Google cobran la mitad a cambio de entregar en un plazo de hasta 24 horas. Anthropic dice que la mayoría de sus lotes terminan en menos de una hora y que su descuento se suma al del caché, aunque en lotes el caché funciona «en lo posible» y suele acertar entre 30% y 98% de las veces, según el uso. Según nuestro cálculo, el ejemplo de la publicación (leer un PDF de 10 páginas y escribir un resumen de mil tokens, con Sonnet 5.5) costaría por lotes de 2 a 3.5 centavos de dólar, en lugar de 4 a 7.
Precios y ventanas de los modelos de hoy
Dólares por millón de tokens, a tarifa estándar, al 17 de octubre de 2026:
| Modelo | Lo que se manda | La respuesta | Desde el caché |
|---|---|---|---|
| Claude Fable 5.1 | 10 | 50 | 0.25 |
| Claude Opus 5.5 | 4 | 20 | 0.20 |
| Claude Sonnet 5.5 | 2 | 10 | 0.10 |
| GPT-6 Astra | 10 | 50 | 1.00 |
| GPT-6.1 Sol | 2 | 10 | 0.10 |
| GPT-6 Luna | 0.10 | 0.50 | 0.01 |
| Gemini 3.8 Flash (hasta el 31 de diciembre) | 0.75 | 3.75 | 0.075 |
Tres reglas que cambian el costo:
- GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna cobran el doble por lo que se manda (también lo que sale del caché), y 1.5 veces la respuesta, en toda la solicitud cuando lo que se manda pasa de 272,000 tokens.
- Claude Fable 5.1, Opus 5.5 y Sonnet 5.5 cobran igual hasta el millón de tokens: una solicitud de 900,000 paga lo mismo por token que una de 9,000.
- Gemini 3.8 Flash duplica su precio el 1 de enero de 2027, y Google cobra el razonamiento como parte de la respuesta.
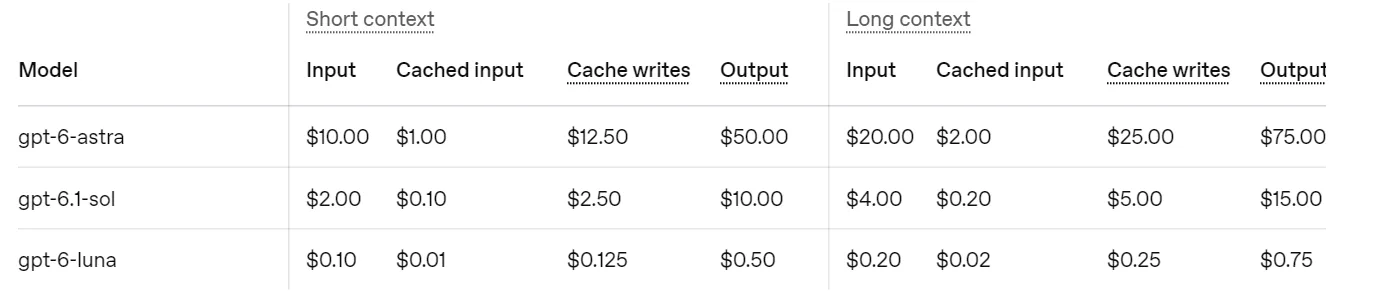
En los modelos actuales de Anthropic, la ventana de contexto es de un millón de tokens, con respuestas de hasta 128,000; en los de OpenAI, de 1,050,000, con respuestas de hasta 128,000. En Gemini 3.8 Flash, lo que se manda tiene su propio tope (1,048,576 tokens) y la respuesta el suyo (65,536). En Claude, todo cuenta para la ventana: las instrucciones, cada mensaje, las herramientas que se le dan al modelo y la respuesta, razonamiento incluido; y en sus modelos que conservan el razonamiento anterior, ese razonamiento vuelve a cobrarse como entrada en las siguientes solicitudes.
Cómo contar los tokens antes de mandar
- OpenAI: el tokenizador web, para probar texto, y
tiktoken, una herramienta para contarlo desde un programa. Para una solicitud completa, con imágenes, archivos o herramientas, tiene una función de su API (la conexión con la que un sistema usa el modelo) que cuenta lo que se manda. Advierte que contar lo que se manda no dice cuántos tokens tendrá la respuesta. - Anthropic: una función de su API para contar, gratuita, con un límite de solicitudes por minuto; el resultado es una estimación.
- Google:
count_tokens, en su API, que cuenta solo lo que se manda.
Cómo ver el consumo y ponerle tope
- OpenAI: su panel de uso muestra el consumo por periodo, en hora UTC (la universal; la del centro de México va 6 horas atrás), a quien sea dueño de la organización o tenga ese permiso.
- Anthropic: en su consola, la página de uso lo desglosa por modelo y por llave de acceso (la clave con la que cada sistema se conecta); la de costo, por modelo; ninguna, por persona. Los niveles de cuenta Start, Build y Scale tienen tope mensual (500 dólares en Start), y se puede fijar uno propio en la facturación. En el chat de Claude, con un plan de pago, el consumo se ve en Configuración > Uso.
- Google: en Google AI Studio, su consola, en el panel de uso. Cada cuenta tiene un tope automático según su nivel, y se puede fijar uno por proyecto (función experimental). Con prepago, cuando el saldo llega a cero, dejan de funcionar todas las llaves de esa cuenta a la vez; el sistema tarda unos 10 minutos en registrar el consumo, y en ese lapso el consumo puede pasar del saldo.
Lo que también se cobra, si pagas por uso
- Usar herramientas agrega instrucciones del sistema: 286 tokens por solicitud en Claude Opus 5.5 y Sonnet 5.5.
- La herramienta de Anthropic que lee páginas web no cobra aparte, pero lo que trae entra como tokens: una página promedio (10 kB), unos 2,500; un artículo científico en PDF (500 kB), unos 125,000.
- La búsqueda web cuesta 10 dólares por cada 1,000 búsquedas en Anthropic y en OpenAI, más los tokens de lo que encuentra.
Fuentes
Consultadas el 9, el 12 y el 17 de octubre de 2026.
OpenAI
- OpenAI, qué son los tokens y cómo contarlos: «A word can be divided into different tokens depending on its spelling, capitalization, and surrounding text»; «Spaces also affect how text is divided into tokens»; «An input count does not predict how many output tokens the model will generate».
- OpenAI, tokenizador. Mediciones propias del 9 y del 17 de octubre de 2026.
- OpenAI, imágenes: «Vision models convert image inputs into billable input tokens»; «ceil(1024 × 1.2) = 1229»; «low does not always use fewer tokens than high». Y PDF: «Text extracted from the PDF is still included».
- OpenAI, caché: «Cache reuse requires the entire rendered prefix to match». Y lotes: «50% lower costs, a separate pool of significantly higher rate limits, and a clear 24-hour turnaround time».
- OpenAI, precios y fichas de GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna: «Prompts with more than 272K input tokens are priced at 2x input and cache rates and 1.5x output for the full request»; «Web search (all models) $10.00 / 1k calls».
- OpenAI, contar tokens: «Get accurate input token counts before sending requests». Y revisar el uso y los costos: «Dashboard data is displayed in UTC».
Anthropic
- Anthropic, imágenes: «Each patch is a 28×28-pixel block of the image, referred to as a visual token»; «High-resolution images can use up to roughly three times more visual tokens than the same image on a standard-tier model».
- Anthropic, precios: los multiplicadores del caché; «A 900k-token request is billed at the same per-token rate as a 9k-token request»; «Average web page (10 kB): ~2,500 tokens»; «$10 per 1,000 searches, plus standard token costs for search-generated content».
- Anthropic, caché: «Cache hits require 100% identical prompt segments»; y lotes: «All usage is charged at 50% of the standard API prices»; «The pricing discounts from prompt caching and Message Batches can stack»; «cache hits are provided on a best-effort basis».
- Anthropic, ventana de contexto: «Cached prompt prefixes still occupy the context window: prompt caching changes what you pay for those tokens, not whether they count». Y sus modelos.
- Anthropic, contar tokens: «Token counting is free to use but subject to requests per minute rate limits»; «The token count is an estimate». Límites de la cuenta, uso y costo en la consola («View usage data by model, date/time, and API key»; «View costs for individual models») y cómo aprovechar el límite del chat: «navigate to Settings > Usage».
- Google, tokens, resolución de imágenes y documentos y documentos: «You are not charged for tokens originating from the extracted native text in PDFs».
- Google, precios (actualizados el 16 de octubre de 2026): «$0.50 / 1,000,000 tokens per hour (storage price)»; caché: «Implicit caching is enabled by default for all Gemini 2.5 and newer models»; el caché que se pide a propósito: «If not set, the TTL defaults to 1 hour»; lotes y facturación: «an automatically assigned spend cap based on your account tier».