 DuneTech Labs
Cómo se le pregunta
Microsoft-Decision-1 recibe un estado (texto o JSON) y una o más preguntas con sus opciones. Su guía en Microsoft Learn describe tres tipos:
| Pregunta | Tipo | Qué devuelve | Para qué, según la guía |
|---|---|---|---|
| ¿Es cierto? | noul | Una probabilidad de 0 a 1 | Filtros y compuertas: si una acción toca datos de producción, si un documento trae una inyección de instrucciones |
| ¿Cuál opción es? | choice | La opción elegida y la probabilidad de cada una | Encaminar solicitudes, clasificar documentos o intenciones, ordenar alertas por causa |
| ¿Cuánto? | score | Un valor en una escala y la probabilidad de cada nivel | Priorizar una cola, calificar una respuesta, medir gravedad o frustración |
No escribe ni explica: la ficha dice que «does not generate explanatory text». Acepta hasta 32,768 tokens de entrada, solo texto, y Microsoft no publica sus pesos. Está basado en Qwen3.5-9B, de Alibaba.
Lo que cambió entre el 9 y el 20 de octubre
| Qué | 9 de octubre | 20 de octubre |
|---|---|---|
| Estado en la ficha de Foundry | «Generally available (GA)» | «Preview» (el blog de Foundry ya decía «public preview» el 9) |
| OpenRouter | «coming soon» | Disponible, a 0.042 dólares por millón de entrada y 0 en salida |
| Segundo más rápido, en el texto del anuncio | Quyet-1.0-Large, 4.5 veces más lento | H2O-Lightning-4B v1.1, 2.5 veces más lento. Su gráfica de latencia ya ponía segundo a H2O-Lightning el 9: se corrigió el texto, no la medición |
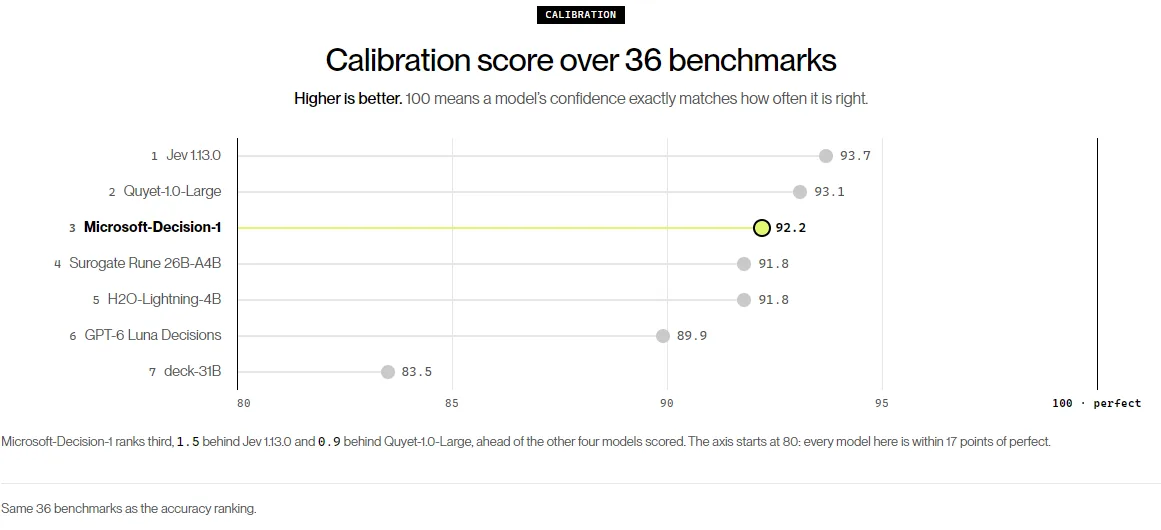
| Calibración en el anuncio | Segundo lugar | Tercero, al agregar a Jev 1.13.0 |
El precio, 0.042 dólares por millón de tokens de entrada, está en el anuncio y en la página de precios de Azure (la salida, «N/A»); la ficha del modelo dice, el 9 y el 20, «The provider has not supplied this information».
Microsoft agregó al anuncio: «Editor’s note: This post was updated from the original to add benchmarks for Jev on accuracy and calibration». En precisión sigue primero en sus 36 pruebas: 83.5% contra 82.3% de Jev, en promedio, según su gráfica. La latencia de 85 ms que publica la midió en Foundry; la de los demás modelos sale de otra prueba, JevBench, así que no son las mismas condiciones.
Dos cosas que no usamos: las cifras de Xbox, porque el anuncio («14 times faster») y el blog de Foundry («80–100 times faster») no dicen lo mismo; y la demo de comprar una mochila con «computer use», porque la ficha dice que el modelo es solo texto.
Lo que midió Artificial Analysis
Artificial Analysis publica mediciones de modelos de IA hechas por su cuenta («All evaluations are conducted independently»). Su índice de modelos de decisión, del 13 de octubre, combina cuatro evaluaciones: clasificación, uso de herramientas, conocimiento con la opción de decir «no sé», y razonamiento.
| Qué midió | Microsoft-Decision-1 | El mejor de los 13 de la gráfica |
|---|---|---|
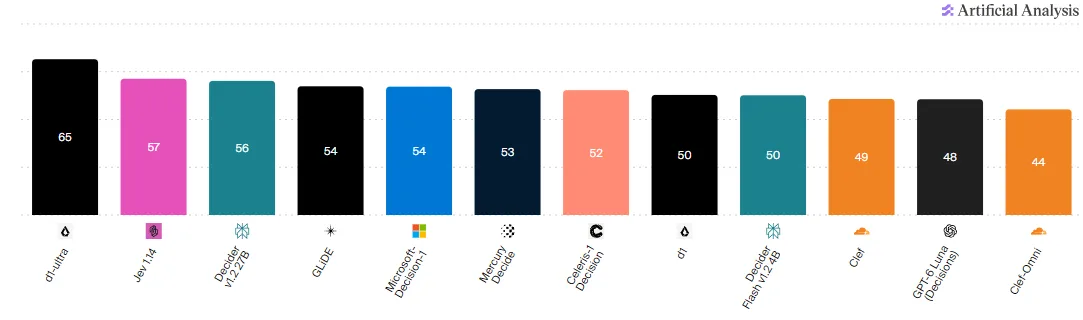
| Índice (22 oct.) | 54, empatado en el quinto lugar con GLiDE | d1-ultra, de Liquid AI, y Elephant 9B, de Baseten: 65 |
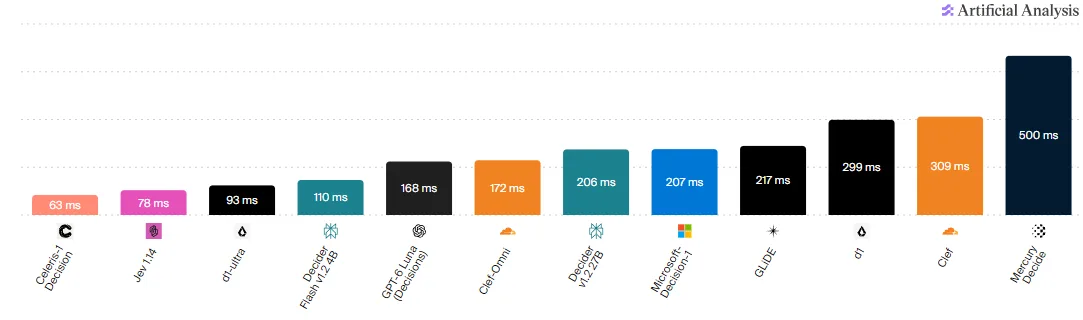
| Tiempo por tarea (22 oct.) | 207 ms, noveno, medido a través de OpenRouter (a los demás, en la API de su fabricante) | Celeris-1 Decision: 63 ms |
| Costo por millón de tareas (22 oct.) | 31 dólares, el sexto más barato | Decider Flash v1.2: 8.2 dólares |
| Dijo «no sé» en lugar de equivocarse (22 oct.) | 40%, tercero (el 13 de octubre, con 9 modelos, era el primero; el 20, segundo) | Elephant 9B: 93% |
Lo que encontró en todos los modelos de decisión que midió:
- Se confían de más. «Across almost all probability levels, accuracy falls below that probability for all decision models»: cuando dicen 90%, aciertan menos. Sobre todo en conocimiento y razonamiento: al clasificar y al decidir qué herramienta usar, «most decision models are relatively well-calibrated».
- Rápidos y baratos, pero saben y razonan menos que un modelo que escribe (cifras del 13 de octubre). En la prueba de conocimiento, Claude Haiku 5.5 y GPT-6 Luna, en su modo «Low», sacan 52 y 66, contra 28 a 41 de los modelos de decisión. En el índice completo, Claude Haiku 5.5 saca 61, pero tarda 1.4 segundos por tarea y cuesta 184 dólares por millón de tareas; Jev 1.13 tarda 0.13 segundos y cuesta 42. GPT-6 Luna en su modo «Low», también de los que escriben, saca 55 a 131 dólares por millón de tareas, contra 31 de Microsoft-Decision-1.
Y un detalle de la guía de Microsoft: el «no sé» solo existe si se lo das como opción. La recomienda «when the model shouldn't make a forced choice»: «Include an abstention option, such as cannot tell».
Los otros modelos de decisión
| Modelo | Empresa | Desde | Precio de entrada, por millón de tokens | Nota |
|---|---|---|---|---|
| Jev | TypeSafe | 15 de septiembre | 0.042 dólares | «available today in early access»; Cloudflare dice que Clef es «in the same family», y Microsoft lo agregó a sus gráficas |
| Clef y Clef-flash | Cloudflare | 1 de octubre | 0.24 y 0.038 dólares | Pesos abiertos, con licencia Apache 2.0 |
| d1 y d1-ultra | Liquid AI | 5 y 15 de octubre | 0.042 dólares (d1-ultra) | d1 y d1-ultra también aceptan imágenes |
| Decisions API (gpt-6-luna) | OpenAI | En «public beta» | 0.10 dólares | Solo se cobra la entrada |
| Microsoft-Decision-1 | Microsoft | 9 de octubre (anuncio) | 0.042 dólares | En vista previa |
Se parecen hasta en la forma de preguntar: la guía de Microsoft dice que «The request pattern is similar to a system-one API», el formato de Jev, que también siguen Clef y d1; el de OpenAI se parece, con otros nombres.
Dónde corre y con qué límites
- Regiones: Estados Unidos, la Unión Europea y Asia-Pacífico. No está en la región de Azure en México («Mexico Central», en Querétaro).
- Dónde se procesan los datos: con un despliegue de zona de datos de EE. UU., «data processed anywhere within the US»; con uno global, en cualquier región de Azure donde esté el modelo.
- Límite de solicitudes por minuto: de 60 a 900, según el nivel de la suscripción de Azure (del 1 al 6), igual en despliegue global y de zona de datos.
- Idiomas: «optimized for English and evaluated in… Spanish», pero su ficha anota como zona débil «Non-English languages». No hay cifras publicadas de cómo le va en español.
Fuentes
Consultadas el 9, el 20 y el 22 de octubre de 2026.
- Microsoft, el anuncio en Command Line, 9 de octubre de 2026, con su versión editada del 20: «achieved the highest accuracy in our 36-benchmark comparison»; «it was the fastest measured: 2.5 times quicker than H2O-Lightning-4B v1.1, the runner-up» (el 9: «4.5 times quicker than Quyet-1.0-Large»); «Editor’s note: This post was updated from the original to add benchmarks for Jev on accuracy and calibration»; «Microsoft-Decision-1 ranks third, 1.5 behind Jev 1.13.0» (el 9: «ranks second»); «Input tokens cost $0.042 USD per million tokens. Output tokens are free»; «competitive on quality with GPT-6 Sol while running over 14 times faster»; «We’ll continue to release updates to the model».
- Microsoft, el blog de Foundry, 9 de octubre de 2026: «Now available in public preview»; «80–100 times faster».
- Microsoft Foundry, la ficha del modelo, copias del 9 y del 20 de octubre: «Generally available (GA)» y luego «Preview»; «does not generate explanatory text»; «up to 32,768 input tokens»; «built on Alibaba's open-weight Qwen3.5-9B»; «Model weights are not distributed»; «optimized for English and evaluated in… Spanish»; «Areas where the model may underperform: Non-English languages»; «not designed for text generation, open-ended question answering, conversation, translation, or summarization»; «should not be used as the sole basis for decisions involving credit, employment, housing, insurance, education, healthcare, legal rights»; «The model is text-only».
- Microsoft Learn, cómo usar Microsoft-Decision-1: los tipos «noul», «choice» y «score»; «The request pattern is similar to a system-one API»; «Use a low top probability as a signal to escalate the decision to a person or another model»; «Choose a probability threshold based on your workload, and validate it against labeled examples before you automate a gate»; «Include an abstention option, such as cannot tell, when the model shouldn't make a forced choice»; «DataZoneStandard in selected regions; GlobalStandard».
- Microsoft Learn, regiones de los modelos que vende Azure, actualizada el 19 de octubre de 2026: regiones de EE. UU., la UE y Asia-Pacífico; «For Data Zone deployments, Microsoft processes prompts and responses anywhere within the specified data zone: United States (data processed anywhere within the US)». Y la lista de regiones de Azure: «Mexico Central».
- Microsoft Learn, cuotas y límites: «Microsoft-Decision-1 quotas», de 60 a 900 solicitudes por minuto, del nivel 1 al 6.
- Azure, precios de los modelos de Microsoft en Foundry: «Microsoft-Decision-1 | $0.042 | N/A | N/A».
- OpenRouter, Microsoft-Decision-1: «$0.042 / $0 per 1M».
- Artificial Analysis, el índice de modelos de decisión, 13 de octubre de 2026: «All evaluations are conducted independently by Artificial Analysis»; «GPT-6 Luna (Low) scores 55… at 1.5 seconds per task and $131 per one million tasks»; «most decision models are relatively well-calibrated on When2Call (tool calling) and WildGuardTest (classification)»; las cuatro evaluaciones; «Microsoft-Decision-1 leads decision models at 40%, followed by Jev 1.13 at 35%» (el 13 de octubre); «Decider v1.1 27B has the lowest Cost per 1M Tasks at $17, with Microsoft-Decision-1 ($31)… also on the Capability vs. Cost Pareto frontier»; «across almost all probability levels, accuracy falls below that probability for all decision models»; «Decision models offer significant speed and cost advantages over language models, but trail on knowledge and reasoning»; «Claude Haiku 5.5 (Low) scores 61… takes 1.4 seconds per task against 0.13 seconds… costs $184 per one million tasks against $42»; «on AA-Omniscience-Decision accuracy, Claude Haiku 5.5 (Low) scores 52 and GPT-6 Luna (Low) 66, against 28 to 41 for decision models». Y la página en vivo, gráficas y datos del 20 de octubre: índice, tiempo por tarea, costo por millón de tareas, el «no sé» (d1-ultra 84.5%, Microsoft-Decision-1 39.8%) y que a Microsoft-Decision-1 lo midió a través de OpenRouter («hostName»: «OpenRouter»). Revisada de nuevo el 22 de octubre: entró Elephant 9B, de Baseten (índice 65, «no sé» 93.2%, 165 ms, 8.4 dólares por millón de tareas), también en la gráfica; las cifras de Microsoft-Decision-1 no cambiaron.
- TypeSafe, Jev: «Our first public model is Jev, available today in early access»; «Input tokens: $0.042 / MTok».
- Cloudflare, Clef en Workers AI, 1 de octubre de 2026: «Clef is a decision model, in the same family as Typesafe's Jev»; «open-sourcing the weights under the Apache 2.0 license»; y sus precios: «Clef-flash – originally $0.09 per M input tokens, now $0.038»; «Clef – remains at $0.24».
- Liquid AI, d1: «our first decision model, now supporting both text and images»; y d1-ultra, 15 de octubre de 2026: «available today on the Liquid API at $0.042 per million input tokens».
- OpenAI, la Decisions API: «The Decisions API is in public beta»; «gpt-6-luna is the only model currently available»; «input costs $0.10 per 1M tokens».