 DuneTech Labs
Cómo trabaja un motor de inferencia
DeepSeek resume el problema así en su guía de despliegue: el modelo marca lo que es posible, y llevar esas capacidades a muchísima gente a un costo razonable es lo que tiene que resolver el motor de inferencia. Su sistema para el modelo DeepSeek-V4.1-Flash tiene estas partes:
- Dos etapas, en máquinas distintas. Leer la entrada (prefill) y escribir la respuesta, token por token (decode), piden cosas distintas: según Huawei, leer pide sobre todo cálculo, y escribir, mucho ancho de banda de memoria. DeepSeek las separa: lee en máquinas comunes de 8 chips y escribe en «supernodos» de 64 a 128 chips. Así ajusta por separado cuánto tarda en empezar la respuesta y cuánto entre un token y el siguiente.
- El almacén de lo ya calculado (la caché KV). Cuando una conversación sigue, el motor no vuelve a leer todo desde el principio: reusa lo que ya calculó. DeepSeek se propone guardarlo más de 72 horas (3 días en las peticiones de agentes, 7 en las del chat), en unos 100 PiB de discos SSD.
- El reparto de carga. Varios repartidores mandan cada petición al chip menos ocupado, tanto al leer como al escribir.
- La traducción de ida y vuelta. DeepSeek Recipe convierte la petición (en el formato de la API) en los tokens que entiende el modelo, y la respuesta de vuelta. Un detalle de seguridad: si un texto del usuario trae algo como
<|User|>, lo trata como texto común, para que no se vuelva una instrucción de control del modelo.
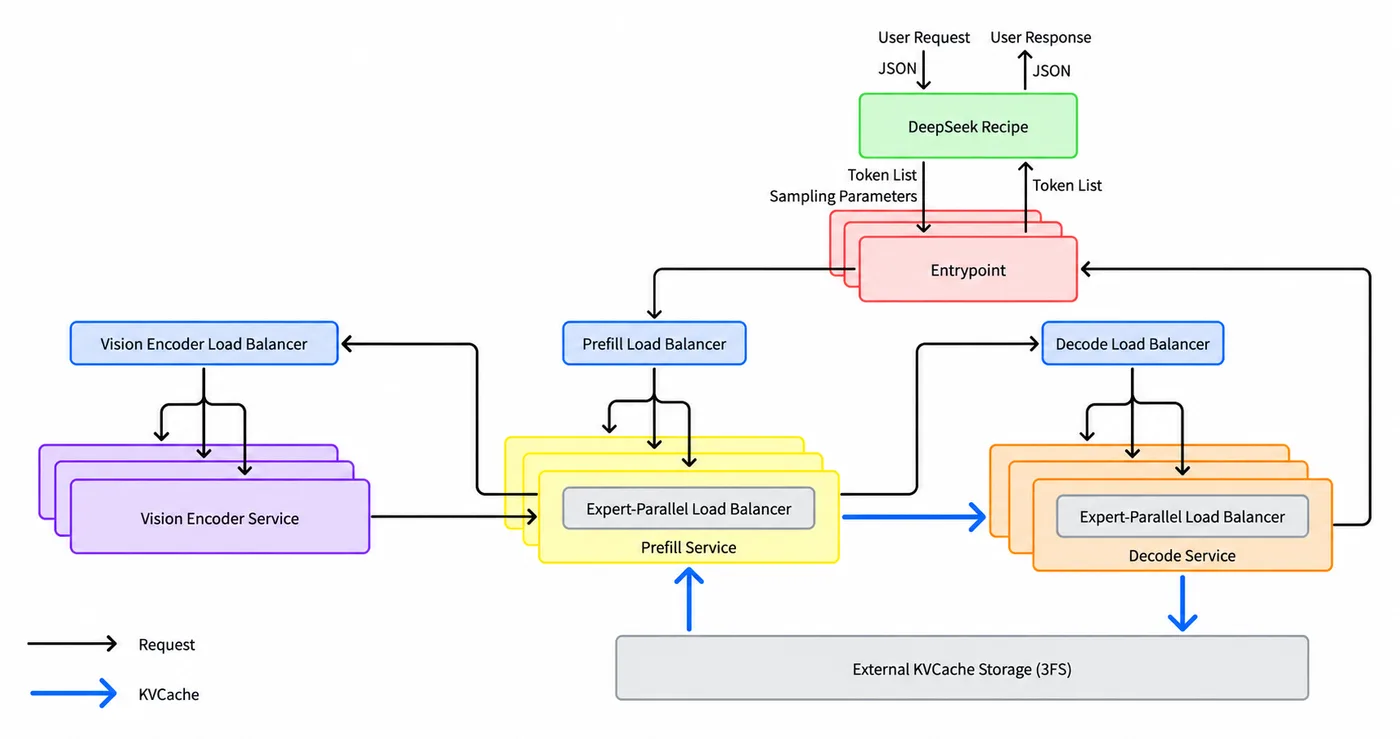
Huawei lleva esa separación a sus chips: en septiembre de 2025 presentó la serie Ascend 950, con una versión para leer la entrada (950PR) y otra para escribir la respuesta y entrenar (950DT). DeepInfer es compatible con la serie Ascend 950.
Qué trae DeepInfer y qué no
Lo que se liberó es el motor, no el sistema completo del diagrama. Su README lo dice así:
| Trae | Qué es |
|---|---|
| Rutinas de cálculo optimizadas | Las bibliotecas de cálculo de DeepSeek (FlashMLA, DeepGEMM, DeepEP y otras). |
| Decodificación especulativa (DSpark) | Un modelo pequeño propone varios tokens y el principal los verifica de una vez; DeepSeek elige cuáles verificar según la confianza de cada uno. |
| Salidas con estructura | Obligar a la respuesta a seguir un formato: un esquema JSON, una expresión regular o una gramática. |
| Resultados repetibles | La misma entrada da la misma salida, aunque cambie el lote de peticiones con el que se procesa. Solo en NVIDIA. |
Qué pide para correr
| Qué | Lo que pide |
|---|---|
| Chips | DeepSeek solo da por compatibles los NVIDIA SM100 y los Huawei Ascend 950. En la tabla de NVIDIA, la capacidad de cómputo 10.0 (SM100) es la de la B200 y la GB200; las RTX de escritorio tienen otra. |
| Programas | Linux, GCC 13 o más nuevo, Python 3.12, y CUDA 13 (NVIDIA) o CANN 9.2 (Ascend). |
| Cuántos chips | «1P + 1D is deployable», pero la configuración que recomienda para escribir es de 64 chips o más, y la proporción entre leer y escribir es de 1 a 1: de ahí la unidad mínima eficiente («smallest efficient deployment unit») de 64 + 64: lo mínimo para que trabaje de forma eficiente. |
| Almacenamiento (en su despliegue) | Para el almacén de lo ya calculado, servidores de 20 discos SSD de 30.73 TB cada uno; en la práctica, unos 14.4 TB por chip. |
| Renta, como referencia | En AWS, la nube de Amazon, en Bloques de capacidad: un servidor p6-b200.48xlarge (8 chips B200), 113.67 dólares por hora en las regiones comerciales de EE. UU. (14.21 por chip); un UltraServer u-p6e-gb200x72 (72 B200), 761.90 dólares por hora en su zona local de Dallas. AWS avisa que el precio se actualiza según la oferta y la demanda. Es renta: NVIDIA y Huawei no publican precio de compra. |
Las gráficas de DeepSeek y cómo se midieron
DeepSeek publicó dos gráficas en el README, medidas con 4 chips para leer y 64 para escribir, con un contexto de 131,072 tokens. DeepSeek no publica la tabla; las cifras que siguen las leímos de las gráficas.
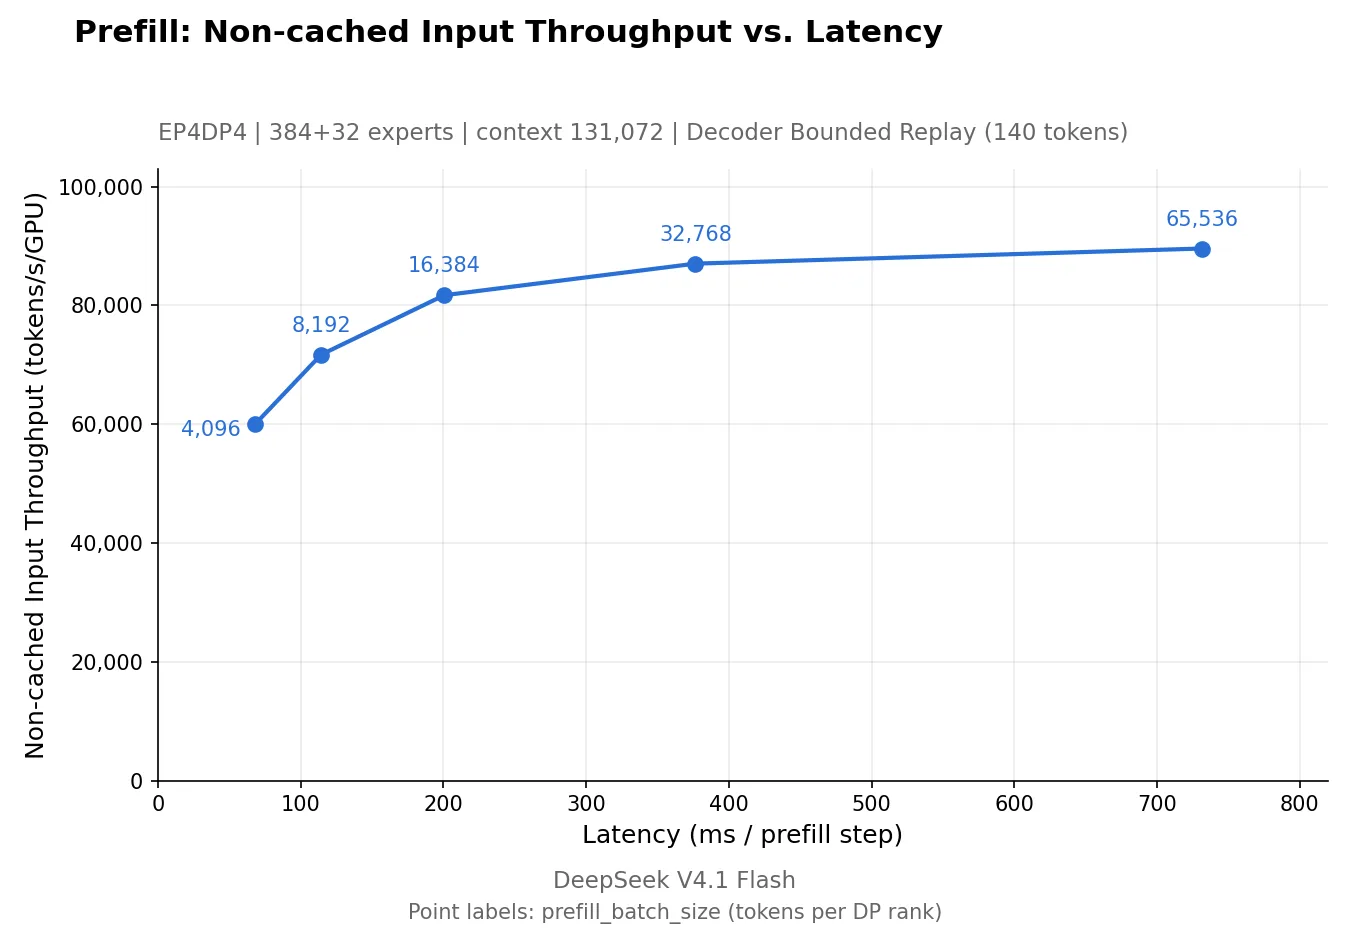
Al leer, cada chip procesa de unos 60,000 a unos 89,500 tokens por segundo, con pasos de unos 70 a unos 730 milisegundos: lotes más grandes rinden más, pero cada paso tarda más.
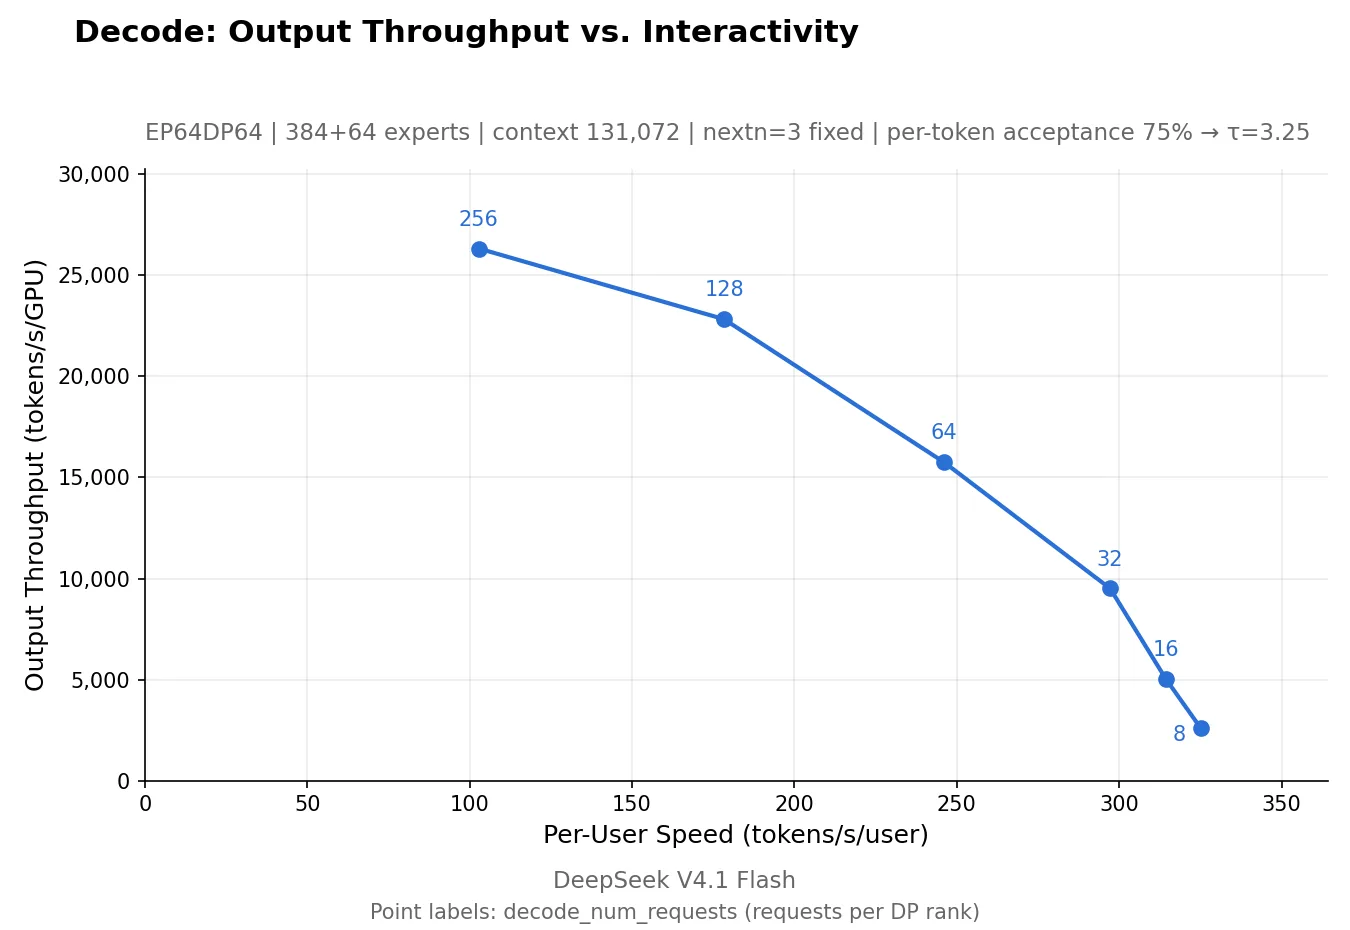
Al escribir pasa lo mismo: con pocas peticiones a la vez, cada chip saca unos 2,600 tokens por segundo y cada usuario recibe unos 325; con muchas, el chip saca unos 26,300 y cada usuario recibe unos 103. En nuestra lectura, ahí está la decisión de costo de un servicio de IA: más gente a la vez abarata cada respuesta, pero cada quien la recibe más despacio.
Otras formas de correr el mismo modelo
DeepInfer es una de varias. Para el mismo modelo, según la guía de cada proyecto:
| Opción | Qué pide | Nota |
|---|---|---|
| DeepInfer | NVIDIA B200 o GB200, o Huawei Ascend 950; eficiente desde 64 + 64 chips | El motor de producción de DeepSeek |
| «Minimal inference», de DeepSeek | 8 chips | «A readable reference implementation rather than a production serving engine» |
| vLLM | Desde 2 chips (2 de los 4 de un módulo GB200 NVL4, pasando parte del modelo a la memoria del servidor) hasta un servidor de 8 H200 sin moverlo; también chips AMD MI300X, MI325X y MI355X; vLLM 0.31.0 o más nuevo | Sus mediciones son de la versión anterior del modelo; la de octubre «have not been separately re-run» |
| SGLang | Recetas para GB300, H200, B200, B300 y MI355X; muestra despliegues de 2 y de 4 chips | Varias configuraciones usan sus imágenes de desarrollo (nightly) |
| Ollama | Solo en su nube (deepseek-v4.1-flash:cloud) | Sin descarga para correrlo en un equipo propio |
Qué quiere decir «gratis»
DeepInfer usa la licencia Apache 2.0. Su sección 2 da permiso «perpetual, worldwide, non-exclusive, no-charge, royalty-free, irrevocable» para copiarlo, modificarlo y distribuirlo, también dentro de un producto que se vende. A cambio, quien lo redistribuya tiene que incluir la licencia y marcar los archivos que cambió (sección 4). No da derecho a usar la marca DeepSeek (sección 6) y se entrega «AS IS», sin garantías (sección 7). El modelo y deepseek-recipe usan la licencia MIT.
Hace año y medio, DeepSeek había decidido no abrir su motor. El 14 de abril de 2025 explicó que estaba «tightly coupled with our internal infrastructure» y que, en lugar de abrirlo, colaboraría con los proyectos abiertos que ya existen (su motor estaba construido sobre vLLM). Ahora lo abrió sin el almacén de lo ya calculado ni el reparto de carga, y promete: «Inference code for future DeepSeek models and ongoing optimizations will land here too».
Fuentes
Consultadas el 20 de octubre de 2026.
- DeepSeek, el anuncio en X, 20 de octubre de 2026: «Introducing DeepInfer, our in-house inference framework, now fully open source»; «help the community lower compute costs, reduce energy use, and make AI more affordable»; «Inference code for future DeepSeek models and ongoing optimizations will land here too»; deepseek-recipe, «aligned with the processing logic behind the official DeepSeek API».
- DeepSeek, el README de DeepInfer: «DeepInfer is the high-performance inference framework that powers DeepSeek's large-scale production services. This open-source release provides offline inference»; «Supported hardware: NVIDIA SM100 GPUs; Huawei Ascend 950 NPUs»; «Required for a complete inference service (not included in this release): A KV cache system; VE/Prefill/Decode disaggregation (most required engine functionality is already implemented); Load balancing across data-parallel replicas for both prefill and decode»; «Batch-invariant inference… (NVIDIA only)»; «Structured outputs: constrain generation to a regex, JSON schema, or EBNF grammar»; «Linux; GCC >= 13.0; Python 3.12; CUDA 13 (NVIDIA only); CANN 9.2 (Ascend only)»; «Measured on 4 SM100 GPUs for prefill and 64 for decode»; «released under the Apache License 2.0»; «originally built primarily on vLLM».
- DeepSeek, la guía de despliegue (preguntas y respuestas): «A model defines the boundary of what is possible; serving those capabilities to a massive user base at a reasonable cost is the core problem an inference framework has to solve»; «ordinary 8-GPU machines for prefill, ordinary 64–128-GPU supernodes for decode»; «so TTFT and TBT can be controlled and optimized independently»; «Retain KV cache for more than 72 hours»; «roughly 100 PiB of SSD storage for the KV cache, with a TTL (time-to-live) of 3 days for agent traffic and 7 days for chatbot traffic»; «1P + 1D is deployable… the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode»; «20 × 30.73 TB SSDs per KV cache storage server»; «about 14.4 TB per GPU»; «tightly coupled to our internal infrastructure»; «we reach roughly 80% of a perfectly balanced offline benchmark»; «preventing text from injecting control tokens that would influence model behavior»; «will be updated continuously».
- DeepSeek, las gráficas y su script: «under full-acceptance accounting — 1 + nextn tokens per request per step, regardless of the true acceptance rate»; en benchmark.py,
torch.randinteignore_eos=True; en plot_pareto.py,--draft_acceptance 0.75; en la gráfica, «per-token acceptance 75% → τ=3.25». - DeepSeek, la licencia de DeepInfer (Apache 2.0): sección 2, «perpetual, worldwide, non-exclusive, no-charge, royalty-free, irrevocable»; sección 4, las condiciones para redistribuir; sección 6, las marcas; sección 7, «AS IS».
- DeepSeek, deepseek-recipe: convierte las peticiones de la API en el formato de conversación y la respuesta de vuelta; «The caller must provide model inference, tool execution, and HTTP transport»; licencia MIT.
- DeepSeek, el modelo DeepSeek-V4.1-Flash-1017 en Hugging Face, publicado el 17 de octubre de 2026: «licensed under the MIT License»; según su API, 763,205,315,794 parámetros y 510,296,920,807 bytes de archivos. Su «Minimal inference»: «A readable reference implementation rather than a production serving engine», con
MP=8. - DeepSeek, por qué no abría su motor, 14 de abril de 2025 (la fecha, del historial del archivo en GitHub: el primer cambio es del 14 de abril de 2025, hora UTC): «our inference engine is built upon vLLM»; «The engine is tightly coupled with our internal infrastructure»; «we’ve decided to collaborate with existing open-source projects as more sustainable alternatives».
- DeepSeek, su entrada en Zhihu, 20 de octubre de 2026: la arquitectura del sistema de inferencia, con el mismo diagrama.
- NVIDIA, capacidades de cómputo de sus chips: 10.0, «NVIDIA GB200» y «NVIDIA B200»; las RTX, 12.0 o menos.
- Huawei, el discurso de Eric Xu en Huawei Connect, septiembre de 2025: «The Ascend 950PR and Ascend 950DT chips will use the same Ascend 950 Die»; «the Ascend 950PR, which is optimized for the prefill stage of inference»; «the Ascend 950DT, which is optimized for both the decode stage of inference and for model training»; el prefill, «compute-intensive… lower demand for memory access bandwidth»; el decode, «high requirements for interconnect bandwidth and memory access bandwidth».
- AWS, precios de los Bloques de capacidad de EC2: p6-b200.48xlarge, «113,666 USD (14,208 USD)»; u-p6e-gb200x72, «761,904 USD (10,582 USD)» (la página en español usa coma decimal), «72 x B200», en la «Zona local del este de EE. UU. (Dallas)»; «Los precios de la reserva se actualizan periódicamente según las tendencias de la oferta y la demanda».
- vLLM, la receta para DeepSeek-V4.1-Flash: «This recipe runs on 2 of 4 GPUs on the selected node», con
--engram-config '{"cpu_offload":true}'; «It fits one GB200 NVL4 tray (768 GB) at TP4, or one 8-GPU H200 node (1128 GB)»; «vLLM 0.31.0+»; MI300X, MI325X y MI355X; «the 1017 weights share its config and footprint but have not been separately re-run». - SGLang, su guía para DeepSeek-V4.1: «launch recipes… for GB300, H200, B200, B300 and MI355X»; la receta verificada, con
--tp 4; despliegues de «2 GPUs» en GB300; «Several are SGLang nightly images». - Ollama, deepseek-v4.1-flash:
ollama run deepseek-v4.1-flash:cloud. - The New Stack, nota del 20 de octubre de 2026 (secundaria, solo confirma): «support is restricted to its SM100 architecture, used in Blackwell data center GPUs»; «Older Nvidia architectures, including Hopper, are conspicuously absent».